Harness engineering : le harnais de vos agents IA expliqué
Le harness engineering, c'est l'art de construire tout ce qui entoure un modèle pour qu'un agent IA produise un travail fiable : instructions, outils, tests, garde-fous, boucles de vérification. Le terme s'est imposé début 2026. Le métier qu'il désigne est beaucoup plus ancien, et c'est précisément ce qui crée la confusion.
La scène circule en ce moment sur LinkedIn, sous une forme ou une autre. Quelqu'un vous explique son « harnais » : Claude Code, Playwright, un AGENTS.md de 8 000 lignes, une bibliothèque de skills versionnée sur GitHub. Puis vous découvrez que, pour vérifier qu'un bouton n'a pas bougé, il demande à chaque fois à un modèle frontière de piloter le navigateur et de raconter ce qu'il voit. Une simple assertion visuelle dans la CI ferait le même travail, sans consommer un seul token.
À l'inverse, beaucoup d'équipes n'ont jamais prononcé le mot « harnais » et ont l'impression d'avoir raté un virage. Elles ont pourtant des tests, un linter strict, une CI exigeante et des conventions écrites. Elles font déjà une bonne partie du travail.
Cet article a un objectif simple : mettre un peu d'ordre. D'où vient le terme, ce qu'il recouvre vraiment, les briques concrètes, ce que disent les retours d'expérience chiffrés, les pièges, et par où commencer.
En bref
- Un agent, c'est un modèle plus un harnais. Le harnais, c'est tout ce qui n'est pas le modèle.
- Le mot désigne trois choses différentes selon le point de vue : l'outil (Claude Code, Codex), votre configuration de cet outil, ou la discipline qui consiste à l'améliorer.
- La règle fondatrice tient en une phrase : chaque fois que l'agent se trompe, modifiez l'environnement pour que l'erreur ne puisse plus se reproduire.
- Le levier le plus rentable reste la vérification déterministe (types, tests, linters). Le LLM juge vient en complément, pas en remplacement.
D'où vient le mot « harnais »
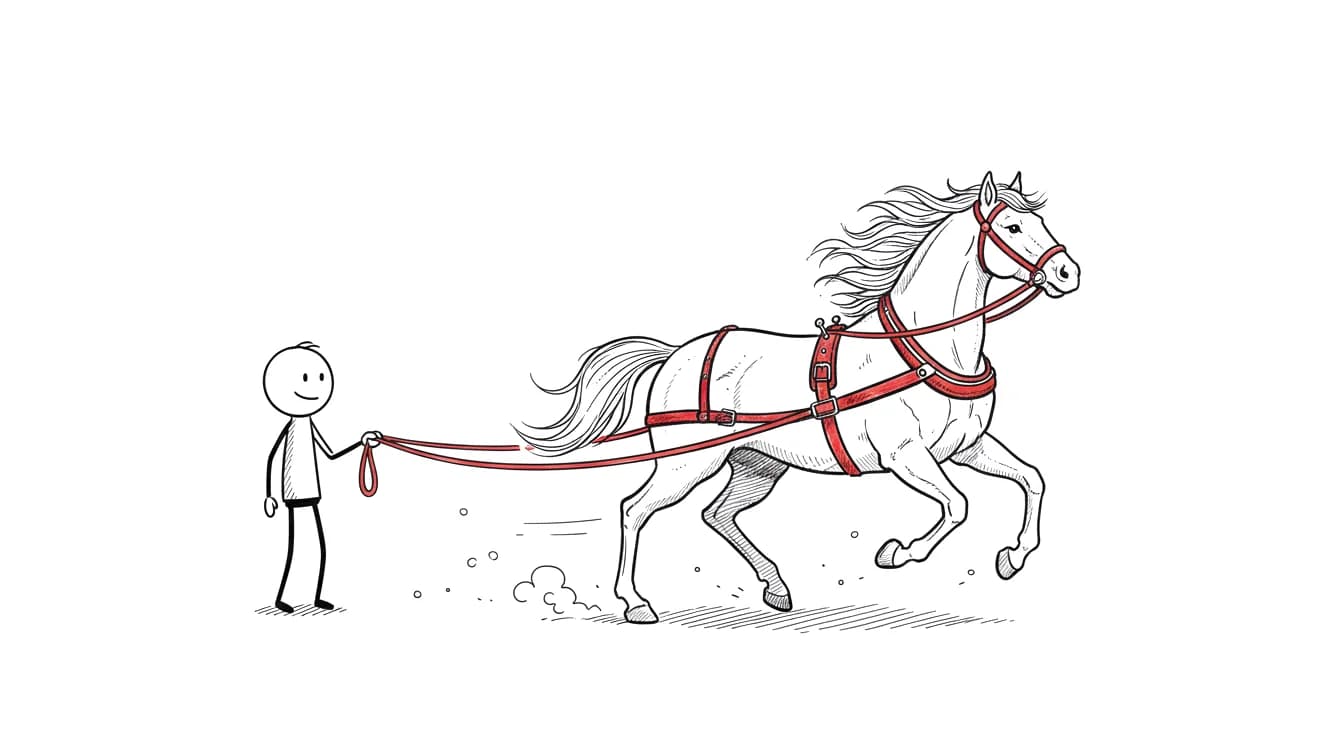
Le mot a fait un aller-retour par l'anglais. Harness vient du vieux français harneis, qui désignait au XIIe siècle l'équipement d'un chevalier, avant de désigner l'attelage d'un cheval (généalogie du terme, arXiv). L'image parle d'elle-même : le modèle est un cheval puissant mais imprévisible, le harnais canalise sa force, l'ingénieur tient les rênes sans courir à sa place.
En informatique, le mot a déjà servi deux fois avant les agents, ce qui entretient la confusion :
| Sens | Ce qu'il désigne | Quand il agit |
|---|---|---|
| Test harness | Le dispositif qui exécute un composant sous test, avec bouchons et collecte de logs | Pendant les tests |
| Evaluation harness | Le banc qui mesure un modèle sur un jeu de tâches (par exemple lm-evaluation-harness) | Après coup, pour noter |
| Agent harness | La couche logicielle qui transforme un modèle en agent capable d'agir | Pendant la tâche |
Le Blog du Modérateur résume bien la différence : le harnais d'agent agit pendant la tâche, le harnais d'évaluation mesure après. Côté terminologie officielle, le Grand Dictionnaire terminologique québécois propose « appareillage agentif », cité par la page Wikipédia « Harnais d'agent ». Dans cet article, nous garderons « harnais », plus parlant.
Comment le terme s'est imposé en quelques mois
Le vocabulaire s'est installé entre novembre 2025 et avril 2026, porté par une poignée de textes fondateurs. Les voici dans l'ordre, car chacun ajoute une pièce différente.
| Date | Texte | Ce qu'il apporte |
|---|---|---|
| 26 nov. 2025 | Effective harnesses for long-running agents, Anthropic | Le mot est déjà là, côté constructeur : comment faire travailler un agent sur plusieurs fenêtres de contexte |
| 5 fév. 2026 | My AI Adoption Journey, Mitchell Hashimoto | L'étape 5, « Engineer the Harness », donne son nom à la pratique côté utilisateur |
| 11 fév. 2026 | Harness engineering: leveraging Codex in an agent-first world, OpenAI | Le retour d'expérience à grande échelle : un produit écrit à 100 % par des agents |
| 17 fév. 2026 | Premier mémo de Birgitta Böckeler sur martinfowler.com | Premier recul critique, remplacé en avril par un article complet |
| 10 mars 2026 | The Anatomy of an Agent Harness, LangChain | La formule : Agent = Modèle + Harnais |
| 12 mars 2026 | Skill Issue, HumanLayer | Le guide pratique des leviers de configuration |
| 24 mars 2026 | Harness design for long-running application development, Anthropic | L'architecture planificateur, générateur, évaluateur |
| 2 avr. 2026 | Harness engineering for coding agent users, Birgitta Böckeler | Le modèle mental le plus utile à ce jour : guides et capteurs |
Un point de précision, car l'erreur est fréquente : ce n'est pas Andrej Karpathy qui a lancé « harness engineering ». On lui doit la popularisation de « context engineering ». Hashimoto lui-même disait ne pas savoir si un terme existait déjà, et se déclarait prêt à en adopter un autre.
Une définition opérationnelle : tout ce qui n'est pas le modèle
La définition la plus nette vient de Vivek Trivedy, chez LangChain : un agent, c'est un modèle plus un harnais, et le harnais regroupe tout le code, la configuration et la logique d'exécution qui ne sont pas le modèle. Autrement dit, si vous n'êtes pas le modèle, vous êtes le harnais.
Ce harnais est indispensable parce qu'un modèle, seul, se contente de recevoir du texte et d'en produire. Il ne garde rien d'une session à l'autre, n'exécute aucun code et ne vérifie pas son travail. La boucle qui le rappelle, les outils, le système de fichiers, la mémoire et la sandbox : tout cela, c'est le harnais.
Toute la confusion vient de ce que le mot vise trois cercles emboîtés, comme le montre Birgitta Böckeler, Distinguished Engineer chez Thoughtworks.
- La discipline : le harness engineering. La pratique continue qui consiste à améliorer le cercle extérieur à partir des erreurs observées.
- Le harnais utilisateur. La couche que vous ajoutez pour votre projet : fichiers d'instructions, skills, serveurs MCP, hooks, tests, linters, CI. C'est de lui que parlent Hashimoto, le retour d'expérience d'OpenAI et la plupart des posts LinkedIn.
- Le harnais constructeur. Claude Code, Codex ou Cursor : la boucle d'agent, le prompt système, les outils natifs, la gestion du contexte. Quand Anthropic ou OpenAI parlent de harnais, c'est souvent de lui. Vous l'achetez plus que vous ne le construisez.
- Le harnais utilisateur. La couche que vous ajoutez pour votre projet : fichiers d'instructions, skills, serveurs MCP, hooks, tests, linters, CI. C'est de lui que parlent Hashimoto, le retour d'expérience d'OpenAI et la plupart des posts LinkedIn.
La règle fondatrice est de Mitchell Hashimoto, cofondateur de HashiCorp : chaque fois qu'un agent commet une erreur, prenez le temps de construire une solution pour qu'il ne la commette plus jamais. Il la décline sous deux formes. D'un côté, un meilleur prompt implicite : dans le projet Ghostty, chaque ligne de l'AGENTS.md correspond à un mauvais comportement observé. De l'autre, de vrais outils programmés, comme des scripts de capture d'écran ou de tests filtrés.
Et le prompt engineering, le context engineering ? Ce ne sont pas des marches d'escalier qui se remplacent, mais des couches qui s'emboîtent. Le prompt engineering optimise un échange. Le context engineering gouverne ce que le modèle voit à un instant donné. Le harness engineering organise l'environnement sur toute la durée de la tâche. HumanLayer y voit un sous-ensemble du context engineering, Böckeler une forme particulière, LangChain l'étape suivante. Peu importe le classement : un mauvais prompt dans un excellent harnais donne toujours un mauvais résultat.
Si vous voulez voir comment Claude Code, Cursor ou GitHub Copilot implémentent concrètement la couche « instructions » de ce harnais (CLAUDE.md, AGENTS.md, skills, MCP), notre analyse comparative du context engineering détaille chaque mécanisme.
Le modèle mental le plus utile : guides et capteurs
Le cadre le plus opérationnel publié à ce jour est celui de Birgitta Böckeler. Il classe chaque élément d'un harnais selon deux axes.
Premier axe : le moment. Les guides (feedforward) agissent avant l'action, pour augmenter les chances que l'agent fasse juste du premier coup. Les capteurs (feedback) agissent après, pour observer le résultat et permettre à l'agent de se corriger. Les deux sont nécessaires : avec des capteurs seuls, l'agent répète les mêmes erreurs ; avec des guides seuls, il suit des règles sans jamais savoir si elles ont fonctionné.
Second axe : la nature. Un contrôle computationnel est déterministe, exécuté par le processeur en quelques millisecondes ou secondes, et fiable : tests, linters, typage. Un contrôle inférentiel fait appel à un modèle pour un jugement sémantique : plus riche, mais plus lent, plus cher et non déterministe.
Croisés, ces deux axes donnent la grille suivante, avec des exemples courants (d'après Böckeler) :
| Computationnel (déterministe, rapide) | Inférentiel (jugement d'un modèle, plus coûteux) | |
|---|---|---|
| Guide (avant l'action) | Scripts de génération de code, configuration du linter, scaffolds, serveur MCP qui expose une CLI | AGENTS.md ou CLAUDE.md, skills, règles de conception en langage naturel |
| Capteur (après l'action) | Types, tests, linters, régression visuelle, hooks de fin de tâche | Agent de revue, évaluateur séparé, LLM juge sur des critères ouverts |
C'est exactement ce que pointait la scène d'introduction. Savoir si un bouton a bougé est une question fermée : elle relève d'un capteur computationnel, comme un test de régression visuelle, pas d'un modèle frontière qui navigue et raconte. Le capteur inférentiel est précieux pour les questions ouvertes : le code est-il surdimensionné, la solution répond-elle au vrai besoin, l'interface est-elle compréhensible ?
Deux conseils pratiques découlent de ce cadre :
- Gardez la qualité à gauche. Les contrôles rapides tournent le plus tôt possible, avant même le commit. Les plus coûteux (mutation testing, revue d'architecture) attendent le pipeline après intégration.
- Écrivez vos messages d'erreur pour l'agent. Un message de linter qui contient l'instruction de correction est une forme positive d'injection de prompt. OpenAI procède exactement ainsi avec ses linters maison.
Enfin, Böckeler distingue trois choses à réguler. La maintenabilité est la plus facile, car l'outillage existe depuis longtemps. L'aptitude architecturale (performance, observabilité) se pilote avec des fitness functions. Le comportement fonctionnel reste le plus dur : la plupart des équipes font encore trop confiance aux tests générés par l'IA elle-même.
Les briques concrètes d'un harnais de coding agent
Un harnais utilisateur se construit avec une dizaine de briques, toutes disponibles aujourd'hui dans Claude Code, Codex ou Cursor. Chacune a un rôle précis, et presque chacune a son piège.
| Brique | Rôle dans le harnais | Ce qu'il faut savoir |
|---|---|---|
| AGENTS.md, CLAUDE.md | Guide injecté au début de chaque session | Une carte, pas une encyclopédie : environ 100 lignes chez OpenAI, qui renvoient vers un dossier docs/ ; moins de 60 lignes chez HumanLayer |
| Skills | Instructions et scripts chargés seulement quand la tâche le demande (divulgation progressive) | Lisez-les avant de les installer : des registres publics ont déjà diffusé des centaines de skills malveillants |
| Serveurs MCP | Brancher de nouveaux outils sur l'agent | Chaque description d'outil occupe du contexte. Si une CLI connue fait l'affaire (gh, docker, psql), elle est souvent plus efficace |
| Sous-agents | Isoler une tâche dans une fenêtre de contexte vierge | Un pare-feu de contexte, pas un jeu de rôle « développeur front » ; permet aussi d'utiliser un modèle moins cher |
| Hooks | Exécuter du code déterministe à des moments clés (fin de tâche, appel d'outil) | Idéal pour lancer le typecheck à chaque arrêt ou refuser une commande de migration ; silencieux quand tout va bien |
| Rétro-pression | Donner à l'agent les moyens de vérifier son travail : types, tests, build, couverture, navigateur | La sortie doit être compacte : n'affichez que les erreurs |
| Sandbox et permissions | Isoler l'exécution, limiter commandes et réseau | Indispensable dès que l'agent tourne sans surveillance |
| Mémoire de passation | Fichier de progression, liste de fonctionnalités, historique git | Anthropic préfère le JSON au Markdown pour les listes que l'agent ne doit pas réécrire |
| Observabilité | Exposer logs, métriques et traces à l'agent | Chez OpenAI, chaque worktree dispose de sa pile éphémère, interrogeable en LogQL et PromQL |
Sources : HumanLayer, OpenAI, Anthropic, LangChain.
Un mot sur les fichiers d'instructions, car c'est la brique la plus mal utilisée. Une étude de l'ETH Zurich (Gloaguen et al., février 2026) a mesuré leur effet réel. Résultat : ils n'améliorent pas, en général, le taux de réussite des tâches, et augmentent le coût d'inférence de plus de 20 % en moyenne. Les vues d'ensemble du dépôt, pourtant recommandées partout, n'aident pas : l'agent découvre la structure seul. Ces fichiers restent utiles pour une chose, signaler les pratiques non standard de votre équipe. Un AGENTS.md de 8 000 lignes n'est donc pas un harnais sophistiqué, c'est un harnais qui encombre.
Même logique pour la sortie des outils. HumanLayer raconte avoir fait tourner la suite de tests complète après chaque modification : 4 000 lignes de tests réussis inondaient le contexte, et l'agent perdait le fil au point d'halluciner. Désormais, un succès est silencieux et seules les erreurs remontent.
Ce que montrent les retours d'expérience chiffrés
Quatre publications donnent des chiffres concrets. Toutes vont dans le même sens : à modèle égal, le harnais change radicalement le résultat, et parfois la facture.
| Source | Expérience | Chiffre clé | Leçon principale |
|---|---|---|---|
| OpenAI, fév. 2026 | Un produit interne construit en 5 mois sans une ligne de code écrite à la main | Environ 1 million de lignes et 1 500 PR, avec 3 puis 7 ingénieurs ; temps estimé à 1/10 d'un développement manuel | Le démarrage a été lent parce que l'environnement était sous-spécifié, pas parce que le modèle était incapable |
| Anthropic, mars 2026 | Même consigne, agent seul contre harnais planificateur, générateur, évaluateur | Seul : 20 min, 9 $, jeu inutilisable. Harnais : 6 h, 200 $, jeu jouable | Un agent qui évalue son propre travail se montre complaisant ; un évaluateur séparé est plus facile à rendre exigeant |
| Can Bölük, fév. 2026 | Changer uniquement le format d'édition de fichiers d'un agent, testé sur 16 modèles | 15 modèles sur 16 progressent ; l'un (Grok Code Fast 1) passe de 6,7 % à 68,3 % de réussite | Souvent, le modèle comprend la tâche mais s'exprime mal à travers ses outils |
| LangChain, mars 2026 | Optimiser le harnais de son agent sur le benchmark Terminal Bench 2.0 | Du top 30 au top 5, sans changer de modèle | Le harnais sur lequel un modèle a été entraîné n'est pas forcément le meilleur pour votre tâche |
Trois enseignements méritent d'être soulignés.
Le réflexe change de nature. Chez OpenAI, quand quelque chose échouait, la réponse n'était presque jamais « réessaie ». La question posée était : quelle capacité manque-t-il à l'agent, et comment la rendre à la fois lisible et vérifiable pour lui ? C'est la règle de Hashimoto, appliquée à l'échelle d'une équipe.
L'entropie devient un sujet à part entière. L'agent reproduit les motifs présents dans le code, y compris les mauvais. L'équipe d'OpenAI consacrait au départ tous ses vendredis, soit 20 % de la semaine, à nettoyer le « slop » généré. Elle a fini par coder des « principes d'or » et par lancer des tâches de fond qui ouvrent de petites PR de refactoring, relues en moins d'une minute : un ramasse-miettes pour la dette technique.
La qualité a un prix. Le harnais d'Anthropic coûtait plus de 20 fois plus cher que l'agent seul. Avec un modèle plus récent, l'équipe a supprimé le découpage en sprints et ramené l'exécution à 3 h 50 pour 124,70 $. Son principe mérite d'être affiché : chaque composant d'un harnais encode une hypothèse sur ce que le modèle ne sait pas faire seul, et ces hypothèses se périment à chaque nouvelle génération de modèles.
Une réserve, enfin : ce sont des récits d'éditeurs et des benchmarks. OpenAI prévient lui-même que son niveau d'autonomie dépend fortement de l'investissement consenti sur ce dépôt précis, et ne doit pas être supposé transposable tel quel.
Les sept pièges les plus fréquents
La plupart des harnais décevants ne pèchent pas par manque d'outils, mais par excès ou par mauvais placement.
- Le harnais obèse. Un fichier d'instructions de plusieurs milliers de lignes, des dizaines de skills et de serveurs MCP installés « au cas où ». Chaque élément consomme du contexte avant même que l'agent commence à travailler. HumanLayer cite explicitement cette approche parmi ce qui n'a pas marché.
- Le LLM pour tout. Confier à un modèle ce qu'un test déterministe ferait mieux, plus vite et gratuitement. Réservez le jugement inférentiel aux questions qu'aucune assertion ne sait trancher.
- L'agent juge et partie. Laisser l'agent valider son propre travail, ou se fier uniquement aux tests qu'il a lui-même écrits. Anthropic a observé son évaluateur repérer de vrais bugs, puis se convaincre qu'ils n'étaient pas graves et valider quand même.
- Les promesses non mesurées. RTK, un proxy qui compresse la sortie du terminal, annonce 60 à 90 % de tokens économisés. JetBrains l'a mesuré sur de vraies tâches d'agent : 7,6 % de coût en plus à faible effort de raisonnement, aucun gain à effort élevé, qualité inchangée. Raison principale : Claude Code lit les fichiers avec ses outils natifs, qui contournent le hook. L'outil n'est pas mauvais, mais un harnais se mesure.
- Le harnais conçu avant les erreurs. Chercher la configuration idéale avant d'avoir rencontré de vrais échecs. La bonne méthode est inverse : partir simple et n'ajouter une brique que lorsqu'un échec réel l'exige.
- La chaîne d'approvisionnement oubliée. Les descriptions d'outils MCP sont injectées dans le prompt système, et les skills peuvent exécuter du code. Un serveur ou un skill non vérifié est une porte ouverte à l'injection de prompt. Traitez-les comme une dépendance npm inconnue.
- Le harnais figé. Chaque composant compense une limite du modèle du moment. À chaque nouvelle génération, retirez un composant à la fois et mesurez : ce qui ne porte plus rien doit partir.
Dernier piège, plus insidieux : il est tout à fait possible de passer plus de temps à peaufiner sa configuration qu'à livrer. HumanLayer le reconnaît sans détour. Le harnais est un moyen, pas un produit.
Nouvelle discipline ou vieux métier renommé ?
Les deux, et c'est une bonne nouvelle pour les équipes qui ont déjà de bonnes pratiques d'ingénierie.
Les sceptiques ont en partie raison. Plusieurs auteurs y voient du platform engineering repeint ou la suite de tests rebaptisée. L'argument tient : dans la plupart des taxonomies publiées, la moitié des couches sont des gates de CI, des tests et des boucles de vérification déterministes. Rien de neuf. Une équipe qui dispose d'un typage strict, d'une CI rapide, de tests fiables et de conventions écrites possède déjà l'essentiel de son harnais.
Mais quelque chose a réellement changé : le lecteur. Le composant que vous encadrez n'est plus déterministe. Il peut inventer une action ou déclarer terminée une tâche qui ne l'est pas, et le harnais doit s'en remettre sans casse. C'est aussi un collègue infatigable mais amnésique : chaque session repart de zéro, comme une équipe d'ingénieurs qui se relaieraient sans jamais se parler, selon l'image d'Anthropic. Pour lui, ce qui ne figure pas dans le dépôt n'existe pas. La discussion Slack qui a tranché un choix d'architecture, la convention que tout le monde connaît sans l'avoir écrite : invisibles.
Böckeler le formule avec justesse : un développeur humain apporte un harnais implicite à chaque base de code. Il a absorbé les conventions, ressent le malaise face à une fonction de 300 lignes, sait que son nom figure sur le commit. Un agent n'a rien de tout cela. Le harness engineering consiste à expliciter ce savoir tacite, en sachant qu'on n'y arrivera jamais complètement. Son objectif n'est donc pas d'éliminer l'humain, mais de concentrer son attention là où elle compte le plus.
Notre lecture chez Hoko : le mot passera peut-être de mode, comme d'autres avant lui. La pratique restera, parce qu'elle prolonge ce qui a toujours fait les bonnes équipes : des contrôles automatisés, des décisions écrites, une boucle d'amélioration continue. Ce qui change, c'est qu'on écrit désormais aussi pour un lecteur qui ne se souvient de rien.
Par où commencer : une démarche en sept étapes
Inutile de tout construire d'un coup. Un bon harnais se construit par cliquet, une erreur corrigée à la fois.
- Faites l'inventaire de l'existant. Typage, tests, linters, CI : c'est votre socle de capteurs computationnels. Dans beaucoup d'équipes, il est déjà là.
- Rendez ces contrôles utilisables par l'agent. Une commande par vérification, rapide, silencieuse en cas de succès, et déclenchée par un hook en fin de tâche pour que l'agent ne puisse pas s'arrêter sur une erreur.
- Écrivez un fichier d'instructions court. Moins de 100 lignes, limité à ce qui est propre à votre équipe, avec des renvois vers la documentation détaillée. Rédigez-le vous-même plutôt que de le faire générer.
- Tenez le journal des erreurs de l'agent. À la deuxième occurrence d'une même erreur, encodez la correction : une ligne d'instruction si c'est simple, un capteur si c'est vérifiable, un skill si c'est une procédure.
- Préférez la règle exécutable à la phrase. Pour chaque nouvelle consigne, demandez-vous si un test ou un linter peut la vérifier. Si oui, écrivez le test. C'est exactement la démarche d'OpenAI : quand la documentation ne suffit pas, la règle devient du code.
- Ajoutez ensuite le jugement du modèle. Un agent de revue ou un évaluateur séparé, réservé aux questions ouvertes, calibré sur des exemples, et distinct de celui qui produit le code.
- Mesurez, puis réévaluez. Taux de tâches réussies du premier coup, volume de retouches humaines, tokens consommés. À chaque nouveau modèle, retirez un composant à la fois pour vérifier qu'il porte encore quelque chose.
Trois questions pour auditer votre harnais en cinq minutes :
- Quand l'agent commet deux fois la même erreur, qu'est-ce qui change dans votre dépôt ?
- L'agent peut-il découvrir seul qu'il a cassé quelque chose, sans qu'un humain le lui dise ?
- Combien de tokens votre harnais consomme-t-il avant même que la tâche commence ?
Pour aller plus loin : un cours ouvert pour apprendre en construisant
Si vous préférez apprendre par la pratique, le dépôt open source Learn Harness Engineering (WalkingLabs, licence MIT) propose un cours structuré en 14 lectures et 8 projets. Les projets font construire progressivement une application Electron de base de connaissances, avec un agent de code, en renforçant son harnais à chaque étape. Le dépôt fournit aussi des modèles réutilisables (AGENTS.md, feature_list.json, init.sh) et existe en 15 langues, dont le français.
Son découpage en cinq sous-systèmes recoupe celui de cet article : instructions, état (progress.md, historique), vérification (tests, linting, typage), portée (une fonctionnalité à la fois) et cycle de vie (initialisation, nettoyage). Sa thèse tient en une phrase : le modèle est intelligent, c'est le harnais qui le rend fiable.
FAQ : questions fréquentes sur le harnais d'agent IA
Qu'est-ce qu'un harnais d'agent IA ?
Un harnais d'agent IA est tout ce qui entoure un modèle de langage pour en faire un agent fiable : boucle d'exécution, outils, instructions, mémoire, sandbox, tests et garde-fous. La formule de LangChain le résume : agent = modèle + harnais. Si un élément n'est pas le modèle, il fait partie du harnais.
Quelle différence entre harness engineering et context engineering ?
Le context engineering gouverne ce que le modèle voit à un instant donné. Le harness engineering est plus large : il organise l'environnement de l'agent sur toute la durée de la tâche (outils, vérifications, boucles de correction, mémoire). Les deux se complètent, et le context engineering est la couche « instructions » du harnais.
Faut-il un AGENTS.md ou un CLAUDE.md long ?
Non. Une étude de l'ETH Zurich (février 2026) montre que les fichiers de contexte n'améliorent pas en général le taux de réussite et augmentent le coût d'inférence de plus de 20 %. Visez moins de 100 lignes, limitées aux pratiques propres à votre équipe, avec des renvois vers une documentation détaillée.
Faut-il un LLM pour vérifier le travail d'un agent ?
Pas par défaut. Tout ce qui se vérifie par une règle fermée (types, tests, linters, régression visuelle) doit être confié à un contrôle déterministe : plus rapide, moins cher, fiable. Réservez le jugement d'un modèle aux questions ouvertes, avec un évaluateur distinct de l'agent qui produit le code.
Par où commencer pour construire son harnais ?
Par l'existant : typage, tests, linters et CI forment déjà votre socle de capteurs. Rendez-les utilisables par l'agent (commande rapide, sortie silencieuse en cas de succès, hook de fin de tâche), écrivez un fichier d'instructions court, puis encodez chaque erreur répétée dans le dépôt. Ajoutez une brique seulement quand un échec réel l'exige.
En conclusion : moins de vocabulaire, plus de boucles
Le harness engineering n'est pas une mode vide, ni un bouleversement. C'est la discipline d'ingénierie appliquée à un nouveau collaborateur : rapide, infatigable, sans mémoire et parfois trop sûr de lui. Les équipes qui s'en sortent le mieux ne sont pas celles qui empilent le plus d'outils, mais celles qui transforment chaque erreur en contrôle, et chaque contrôle en boucle rapide et déterministe.
Si vous ne deviez retenir qu'une chose : avant de demander à un modèle de vérifier, demandez-vous si un test peut le faire.
C'est précisément ce que nous travaillons avec les équipes que nous accompagnons chez Hoko, que ce soit pendant le Bootcamp Agentic Coding (fichiers d'instructions, skills, MCP, hooks, workflow structuré, présenté en détail ici) ou en mission de CTO as a Service pour structurer l'usage des agents dans une équipe existante. Discutons de votre projet : hello@hoko.team.
Sources
- My AI Adoption Journey, Mitchell Hashimoto, 5 février 2026
- Harness engineering: leveraging Codex in an agent-first world, Ryan Lopopolo, OpenAI, 11 février 2026
- Harness engineering for coding agent users, Birgitta Böckeler, martinfowler.com, 2 avril 2026
- The Anatomy of an Agent Harness, Vivek Trivedy, LangChain, 10 mars 2026
- Skill Issue: Harness Engineering for Coding Agents, HumanLayer, 12 mars 2026
- Effective harnesses for long-running agents, Justin Young, Anthropic, 26 novembre 2025
- Harness design for long-running application development, Prithvi Rajasekaran, Anthropic, 24 mars 2026
- Evaluating AGENTS.md: Are Repository-Level Context Files Helpful for Coding Agents?, Gloaguen et al., ETH Zurich, février 2026
- We improved 15 LLMs at coding in one afternoon. Only the harness changed., Can Bölük, 12 février 2026 (l'adresse redirige vers stencil.so/blog/the-harness-problem)
- rtk Claude Code Token Savings: A Skill Trial Benchmark, JetBrains, juillet 2026
- Learn Harness Engineering, WalkingLabs, cours open source (licence MIT)
- What is Harness Engineering? Why the AI Industry's Newest Buzzword is an Old Idea, mai 2026
- Harness Engineering Is the Test Suite, Renamed, DEV Community, 2026
- Qu'est-ce qu'un harnais d'agent IA ?, Blog du Modérateur, 2026
- Harnais d'agent, Wikipédia
- What makes a harness a harness, arXiv, 2026 (généalogie du terme)
Vous voulez industrialiser le développement assisté par IA dans votre équipe ?
Trente minutes pour cadrer votre contexte et voir ce que l'agentic engineering changerait chez vous.